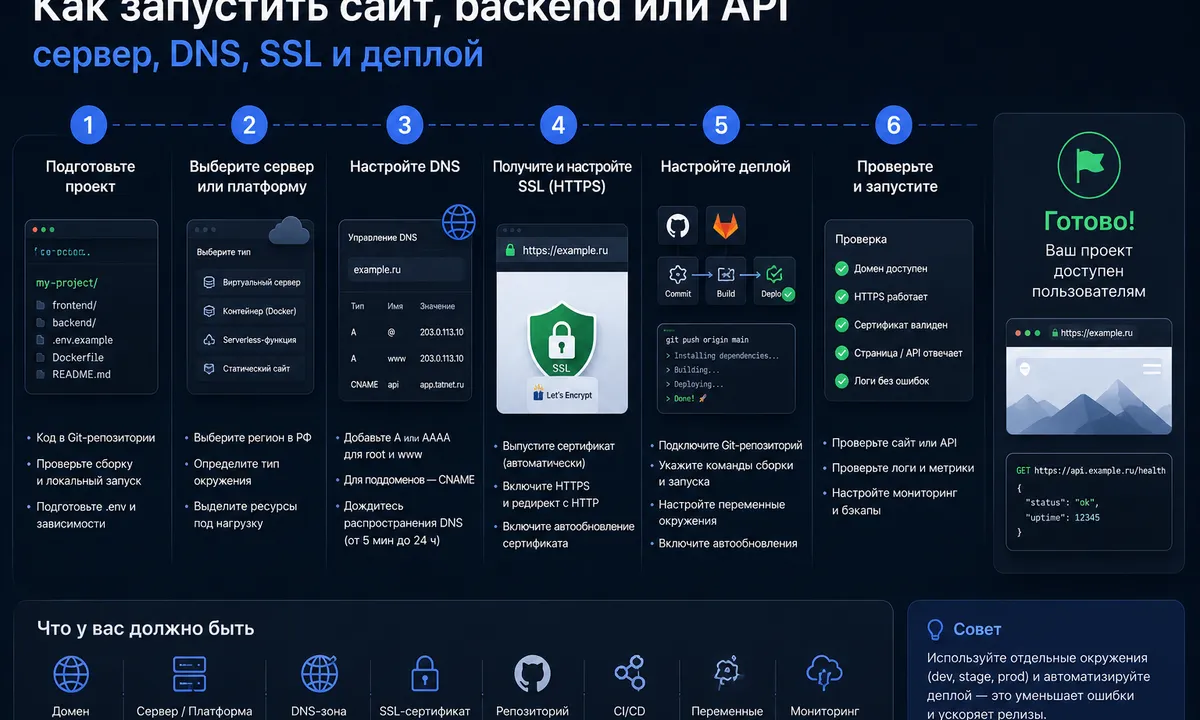
Запустить веб-проект в интернете — это не одна задача, а пайплайн из шести-семи шагов: сервер, код на сервере, сборка, домен и DNS, SSL, запуск приложения, обновления.
Каждый шаг по отдельности понятен. Документации хватает, гайдов в сети — тоже. Но в сумме они занимают ощутимое время и часто ломаются на стыках: сборка прошла, а сервис не стартует; сертификат выпустился, а DNS ещё не обновился; деплой сработал, но приложение не пересобралось.
Разбираем полный workflow запуска: что именно нужно сделать на каждом шаге, какие подводные камни, и где этот путь можно сократить.
Что мы вообще запускаем
Сразу зафиксируем три типичных случая — для них workflow различается на части шагов.
- Статический сайт. Лендинг, портфолио, документация, блог на статическом генераторе. Готовый HTML/CSS/JS, никакого backend.
- Backend или API. Сервис, который обрабатывает запросы: REST API, админка, Telegram-бот, микросервис. Нужен runtime, постоянный процесс, обычно — база данных.
- Fullstack-проект. Frontend + backend + база. По сути — комбинация первых двух.
Дальше по тексту я буду помечать шаги, которые отличаются для этих трёх случаев.
Шаг 1. Сервер: где будет работать проект
Первое решение — где физически будет крутиться код.
Базовых вариантов четыре.
- VPS. Виртуальный сервер с чистой ОС. Полный контроль, но всё нужно настраивать самостоятельно.
- IaaS-облако. Тот же VPS, но с API, эластичным масштабированием и интеграцией с managed-сервисами провайдера.
- PaaS-платформа. Готовая среда, в которую вы приносите код, а платформа берёт на себя сервер, сборку, деплой и HTTPS.
- Static hosting. Узкоспециализированный сценарий для статических сайтов — без сервера в классическом смысле, только раздача файлов.
Что выбрать под каждый из трёх случаев.
Для статического сайта — static hosting или PaaS. Брать VPS под лендинг — избыточно: вы потратите время на настройку nginx ради того, что хостится бесплатно.
Для backend или API — VPS, IaaS или PaaS. На VPS вы получаете полный контроль и делаете всё сами. На PaaS — приносите Dockerfile и получаете запущенный сервис.
Для fullstack — почти всегда удобнее, когда frontend и backend живут на одной платформе с общей моделью доменов, переменных окружения и приватной сети. Это либо PaaS, либо самостоятельно собранная инфраструктура на IaaS.
Подводные камни.
- Ресурсы. Минимальный VPS на 1 ГБ RAM подходит не для всех приложений: Node.js или Java-сервис может не влезть. Лучше с запасом.
- Регион. Сервер в европейском регионе и пользователи в России — это лишние 50–100 мс задержки на каждый запрос. Выбирайте регион ближе к аудитории.
- Доступы. После создания VPS у вас появятся root-пароль и SSH-ключ. Сразу настройте вход по ключу и отключите вход по паролю — это базовая безопасность, про которую часто забывают.
Шаг 2. Код на сервере: как он туда попадёт
После того как сервер появился, нужно как-то перенести на него код.
Вариантов несколько.
Ручная заливка. FTP, scp, rsync. Работает один раз, но превращается в проблему, когда деплоев становится больше одного в неделю. Каждый раз нужно вспомнить, какие файлы поменялись, и не забыть скопировать их все.
Git-pull на сервере. На сервере клонируется репозиторий, и при каждом обновлении делается git pull. Уже лучше — есть история изменений, легко откатиться. Но сборку и рестарт сервиса всё равно нужно запускать руками.
CI/CD-пайплайн. GitHub Actions, GitLab CI или собственный скрипт. По push в нужную ветку запускается сборка, артефакты копируются на сервер, сервис рестартует. Это рабочее решение, но настраивать его — отдельная задача на пару дней. И поддерживать тоже: пайплайны ломаются от обновлений зависимостей и изменений в инфраструктуре.
Git-деплой PaaS. На платформе подключается репозиторий, и деплой запускается автоматически при каждом push. Сборка, выкладка, рестарт — всё внутри платформы. Настройки — выбор ветки, переменные окружения, build-команда.
Подводный камень. На VPS типичная история — deploy.sh, который пишется за полчаса, а через год оброс костылями: sleep 5, потому что иначе сервис не успевает остановиться, отдельная ветка для бэкапа базы перед миграцией, забытый npm install для нативных модулей. Никто уже не помнит, зачем там всё это, но удалить страшно.
Если деплоев планируется больше нескольких в месяц — закладывайте автоматизацию сразу. Ручной деплой не масштабируется.
Шаг 3. Сборка: как проект превращается в работающее приложение
Между «код в репозитории» и «работающее приложение на сервере» стоит сборка. Здесь, по моим наблюдениям, ломается чаще всего.
Для frontend-проекта сборка — это запуск build-команды фреймворка. Next.js — next build. Nuxt — nuxt build или nuxt generate. Vite — vite build. Astro — astro build. На выходе появляется директория с готовыми файлами: dist, .next, .output или build — у каждого фреймворка своё.
Что нужно проверить перед сборкой:
- версия Node.js, на которой собирается проект, совпадает с версией на сервере;
- package manager (npm, yarn, pnpm) тот же, что использовался при разработке — иначе lock-файл не отработает корректно;
- переменные окружения для production-сборки заданы (особенно те, что вшиваются в бандл —
NEXT_PUBLIC_*и аналоги).
Для backend-проекта сборка — это обычно создание Docker-образа из Dockerfile. Сборка определяет:
- базовый образ и runtime (Node, Python, Go, Java);
- установку зависимостей;
- копирование исходников;
- команду запуска;
- порт, на котором сервис слушает.
Хороший Dockerfile использует multi-stage build: одна стадия для сборки, другая — для финального образа. Это уменьшает размер и убирает лишние зависимости.
Где сборка ломается чаще всего.
- Локально работает, на сервере нет. Обычно — разные версии Node или Python. Лечится фиксацией версии в
.nvmrc,package.json(engines) или Dockerfile. - Output directory не там, где ожидается. Деплой-скрипт ищет
dist, а Next.js сложил всё в.next. Проверьте build output фреймворка перед настройкой деплоя. - Сборка падает по памяти. На минимальном VPS Node.js может не собрать большой проект — не хватает RAM. Решение: либо собирать в CI и копировать готовые артефакты, либо взять сервер побольше.
- Зависимости собираются нативно. Пакеты с native-bindings (sharp, sqlite3, bcrypt) требуют компиляции под конкретную ОС и архитектуру. Образ, собранный на macOS ARM, не запустится на Linux x86 без пересборки.
Шаг 4. Домен и DNS: как пользователи попадут на ваш сайт
Сервер работает, приложение запущено — но обращаться к нему по IP-адресу никто не будет. Нужен домен.
Базовая схема такая: вы покупаете домен у регистратора, в панели регистратора прописываете DNS-записи, которые указывают на ваш сервер.
Какие записи нужны.
- A-запись — связывает домен (или поддомен) с IPv4-адресом сервера. Самый частый случай: A-запись на корневой домен и A-запись на
www. - AAAA-запись — то же самое, но для IPv6. Если сервер поддерживает IPv6, заводите.
- CNAME — алиас одного домена на другой. Используется, когда вы подключаете домен к сервису, который даёт вам не IP, а доменное имя (часто — у PaaS-платформ).
Если платформа выдала вам адрес вида myproject.tatnet.ru, корневой домен подключается через CNAME, а не A-запись. У некоторых регистраторов CNAME на корневой домен не работает — для этого есть ALIAS или ANAME-записи, поищите их в панели.
Подводные камни DNS.
- Propagation. DNS-записи обновляются не мгновенно. После того как вы поменяли запись, изменение распространяется по DNS-серверам — это занимает от нескольких минут до 24–48 часов. Это нормально, не повод паниковать.
- TTL. Time To Live — сколько секунд DNS-сервера хранят запись в кэше. Перед тем как менять важные записи, заранее снизьте TTL до 300 секунд — тогда переключение пройдёт быстрее.
- Забытые записи у регистратора. Частая ситуация: домен покупался год назад, тогда же кто-то прописал записи на старый сервер. Сейчас вы прописываете новые — а старые остались, и трафик уходит непонятно куда. Перед настройкой проверьте, что в панели регистратора нет лишнего.
- Кэш браузера и локальной сети. Если вы видите старую версию сайта после смены DNS, проверьте через
dig,nslookupили сервисdnschecker.org— вполне может быть, что это просто ваш кэш.
Шаг 5. SSL/HTTPS: чтобы браузеры не показывали предупреждения
HTTPS сейчас — обязательный минимум. Без него браузеры показывают предупреждение «Не защищено», поисковики занижают сайт в выдаче, многие API (геолокация, push-уведомления, service workers) просто не работают.
Как обычно делают на VPS. Стандартный путь — Let’s Encrypt и certbot. Это бесплатные сертификаты, которые выпускаются автоматически и обновляются раз в 90 дней.
Базовая последовательность:
- Установить
certbotна сервер. - Запустить команду выпуска сертификата для нужного домена.
certbotпроверит, что домен действительно ваш (через HTTP-challenge или DNS-challenge), и положит сертификаты в/etc/letsencrypt/live/yourdomain/.- Прописать пути к сертификатам в конфиге nginx.
- Настроить cron-задачу или systemd-таймер на автообновление.
Где это ломается.
- Автообновление настроено, но падает молча.
certbot renewработает, но нужный сервис не перезапускается с новым сертификатом — клиенты получают истёкший. Проверяйте, что вrenew_hookуказан правильный рестарт. - Rate limit. Let’s Encrypt ограничивает количество выпусков на домен — 50 в неделю на регистрационный домен. Если вы тестируете и часто перевыпускаете — можете упереться в лимит и не сможете выпустить сертификат несколько часов или дней.
- Сертификат на домен, который ещё не указывает на сервер. Если DNS ещё не обновился, HTTP-challenge не пройдёт. Дождитесь propagation или используйте DNS-challenge.
На платформах с авто-HTTPS этот шаг сводится к одному действию: подключили домен — сертификат выпустился. Обновляется тоже сам. Если что-то не так — платформа показывает понятную ошибку, а не молчаливый сбой.
Шаг 6. Запуск приложения: как сделать так, чтобы оно работало после ребута
Для статического сайта этого шага нет — файлы раздаёт веб-сервер, и думать тут не о чем.
Для backend всё интереснее. Если вы запустили приложение командой в терминале и закрыли SSH — оно остановится. Нужно сделать так, чтобы процесс жил постоянно и автоматически стартовал после ребута сервера.
Варианты на VPS.
- systemd. Стандартный способ в современных Linux-дистрибутивах. Пишете unit-файл, регистрируете сервис, он работает в фоне и стартует при загрузке системы. Поддерживает автоматический рестарт при падении.
- pm2. Менеджер процессов для Node.js. Удобнее systemd для Node-приложений: легко смотреть логи, рестартовать, мониторить память. Но это ещё одна сущность, которую нужно поддерживать.
- supervisor. Старый знакомый из мира Python. Делает примерно то же, что systemd, но проще в конфигурации.
- Docker. Самый универсальный способ. Контейнер запускается в фоне, рестарт-политика прописывается в
docker runилиdocker-compose.yml. Работает одинаково для любого языка.
Healthcheck. Любой из этих способов умеет проверять, что приложение действительно живо — отвечает ли оно на запрос или просто висит. Healthcheck лучше настраивать сразу: иначе вы узнаете о падении из жалоб пользователей.
Логи. Отдельный больной вопрос на VPS. По умолчанию приложение пишет в stdout, systemd собирает в journald, Docker — во внутренний storage драйвера. Чтобы потом эти логи читать, нужно либо помнить нужные команды (journalctl -u myservice -f), либо ставить отдельный сборщик логов. На практике часто заканчивается тем, что логи никто не смотрит, пока что-то не сломается.
На PaaS запуск приложения сводится к указанию команды старта (или это берётся из Dockerfile/CMD). Healthcheck, рестарт при падении, логи, мониторинг базовых метрик — встроены. Логи доступны через интерфейс платформы, без SSH.
Шаг 7. Обновления: как выкатывать новые версии
Запустить проект один раз — это половина работы. Дальше нужно его обновлять.
Ручной деплой. Зашли по SSH, сделали git pull, пересобрали, рестартанули сервис. Работает на старте, но ломается на масштабе:
- легко забыть один из шагов (
npm installпосле изменения зависимостей); - между остановкой старой версии и стартом новой пользователи видят ошибку;
- если новая версия не запустилась, откатиться сложно — старого артефакта уже нет;
- человеческий фактор. Попробуйте катнуть прод в пятницу в 23:00 — и поймёте.
CI/CD на VPS. Пайплайн в GitHub Actions или GitLab CI собирает проект, пушит артефакт на сервер, перезапускает сервис. Это решает проблему ручных шагов, но не решает проблему downtime: между остановкой и стартом новой версии всё равно есть пауза.
Чтобы убрать downtime, нужен blue-green deployment или rolling update — два инстанса приложения, балансировщик, переключение трафика. Это полноценная инфраструктурная задача на отдельный день работы.
Git-push → автодеплой на PaaS. На платформе при push в нужную ветку запускается сборка, поднимается новая версия рядом со старой, healthcheck проверяет, что она работает, трафик переключается без downtime. Если что-то пошло не так — старая версия остаётся живой и платформа не переключает трафик.
Откат. Что делать, когда обновление сломало прод. На VPS откат — это либо git revert и заново весь пайплайн, либо ручное восстановление из бэкапа артефакта (если он у вас вообще есть). На PaaS обычно есть кнопка «откатиться к предыдущей версии» — это делается за секунды.
Полный чек-лист
Сводим всё в одно место. Полный пайплайн запуска веб-проекта:
- Сервер. Выбрать тип инфраструктуры под задачу: static hosting, VPS, IaaS, PaaS. Учесть размер, регион, доступы.
- Код на сервере. Настроить способ доставки кода: Git-pull, CI/CD или Git-деплой на платформе.
- Сборка. Зафиксировать версии runtime, package manager, переменные окружения. Проверить output directory. Для backend — собрать Docker-образ.
- Домен и DNS. Купить домен, прописать A-записи или CNAME. Учесть propagation и TTL. Убрать старые записи.
- SSL. Настроить Let’s Encrypt и автообновление, либо использовать платформу с авто-HTTPS. Проверить, что rest сервиса перезапускается с новым сертификатом.
- Запуск. Настроить systemd / pm2 / Docker для постоянной работы процесса. Подключить healthcheck. Решить, как смотреть логи.
- Обновления. Настроить автоматический деплой. Подумать про downtime и откат. Иметь план «что делать, если новая версия сломана».
Проходя этот чек-лист в первый раз, закладывайте день-два полного рабочего времени. Со второго проекта будет быстрее, но всё равно — это часы, а не минуты.
Где этот путь становится короче
В PaaS-модели большинство шагов из чек-листа закрывается платформой. Не из «магии», а потому что эти шаги однотипны для большинства проектов и их можно стандартизировать.
Что не нужно делать, если деплой идёт через TatNet:
- настраивать сервер — приложение запускается на инфраструктуре платформы;
- писать deploy-скрипты — деплой запускается из Git при push;
- разбираться с output directory фреймворка — сборка популярных фреймворков (Next.js, Nuxt, Vite, Astro, React, Vue) определяется автоматически;
- настраивать systemd или pm2 — backend на Docker запускается с healthcheck и автоматическими рестартами;
- ставить и настраивать certbot — HTTPS работает после подключения домена, обновляется сам;
- собирать blue-green deployment — обновления выкатываются без downtime, откат — кнопкой;
- настраивать сборщик логов — логи доступны в интерфейсе платформы.
Что остаётся в зоне ответственности разработчика: код, переменные окружения, выбор домена, миграции базы данных. То есть — собственно работа над продуктом.
Если хотите посмотреть, как это выглядит на практике — есть quickstart с разворачиванием проекта из Git за несколько минут.
Итог
Запуск проекта — это пайплайн, и точки боли всегда находятся на стыках. Сборка прошла, но не скопировалась в нужную директорию. Сертификат выпустился, но nginx не перечитал конфиг. Деплой сработал, но новая версия не пересобрала миграции базы.
Каждый отдельный шаг изучается за пару часов. Но собрать всё вместе и поддерживать в работающем состоянии — отдельная инженерная работа, которая занимает гораздо больше времени, чем кажется на старте.
Понимание workflow целиком — это уже половина дела. Дальше у вас два варианта: аккуратно собрать пайплайн руками и поддерживать его, либо выбрать платформу, которая закрывает большую часть шагов из коробки. Какой вариант подойдёт — зависит от того, сколько в проекте инфраструктурной специфики и сколько времени команда готова тратить на эксплуатацию.