Из России с API OpenAI — тем самым ChatGPT API — работать неудобно: карта не проходит, регион не поддерживается, счёт приходит в долларах, а запросы из CI идут через VPN, который периодически отваливается. С Codex CLI то же самое: инструмент отличный, но платить за него нечем.
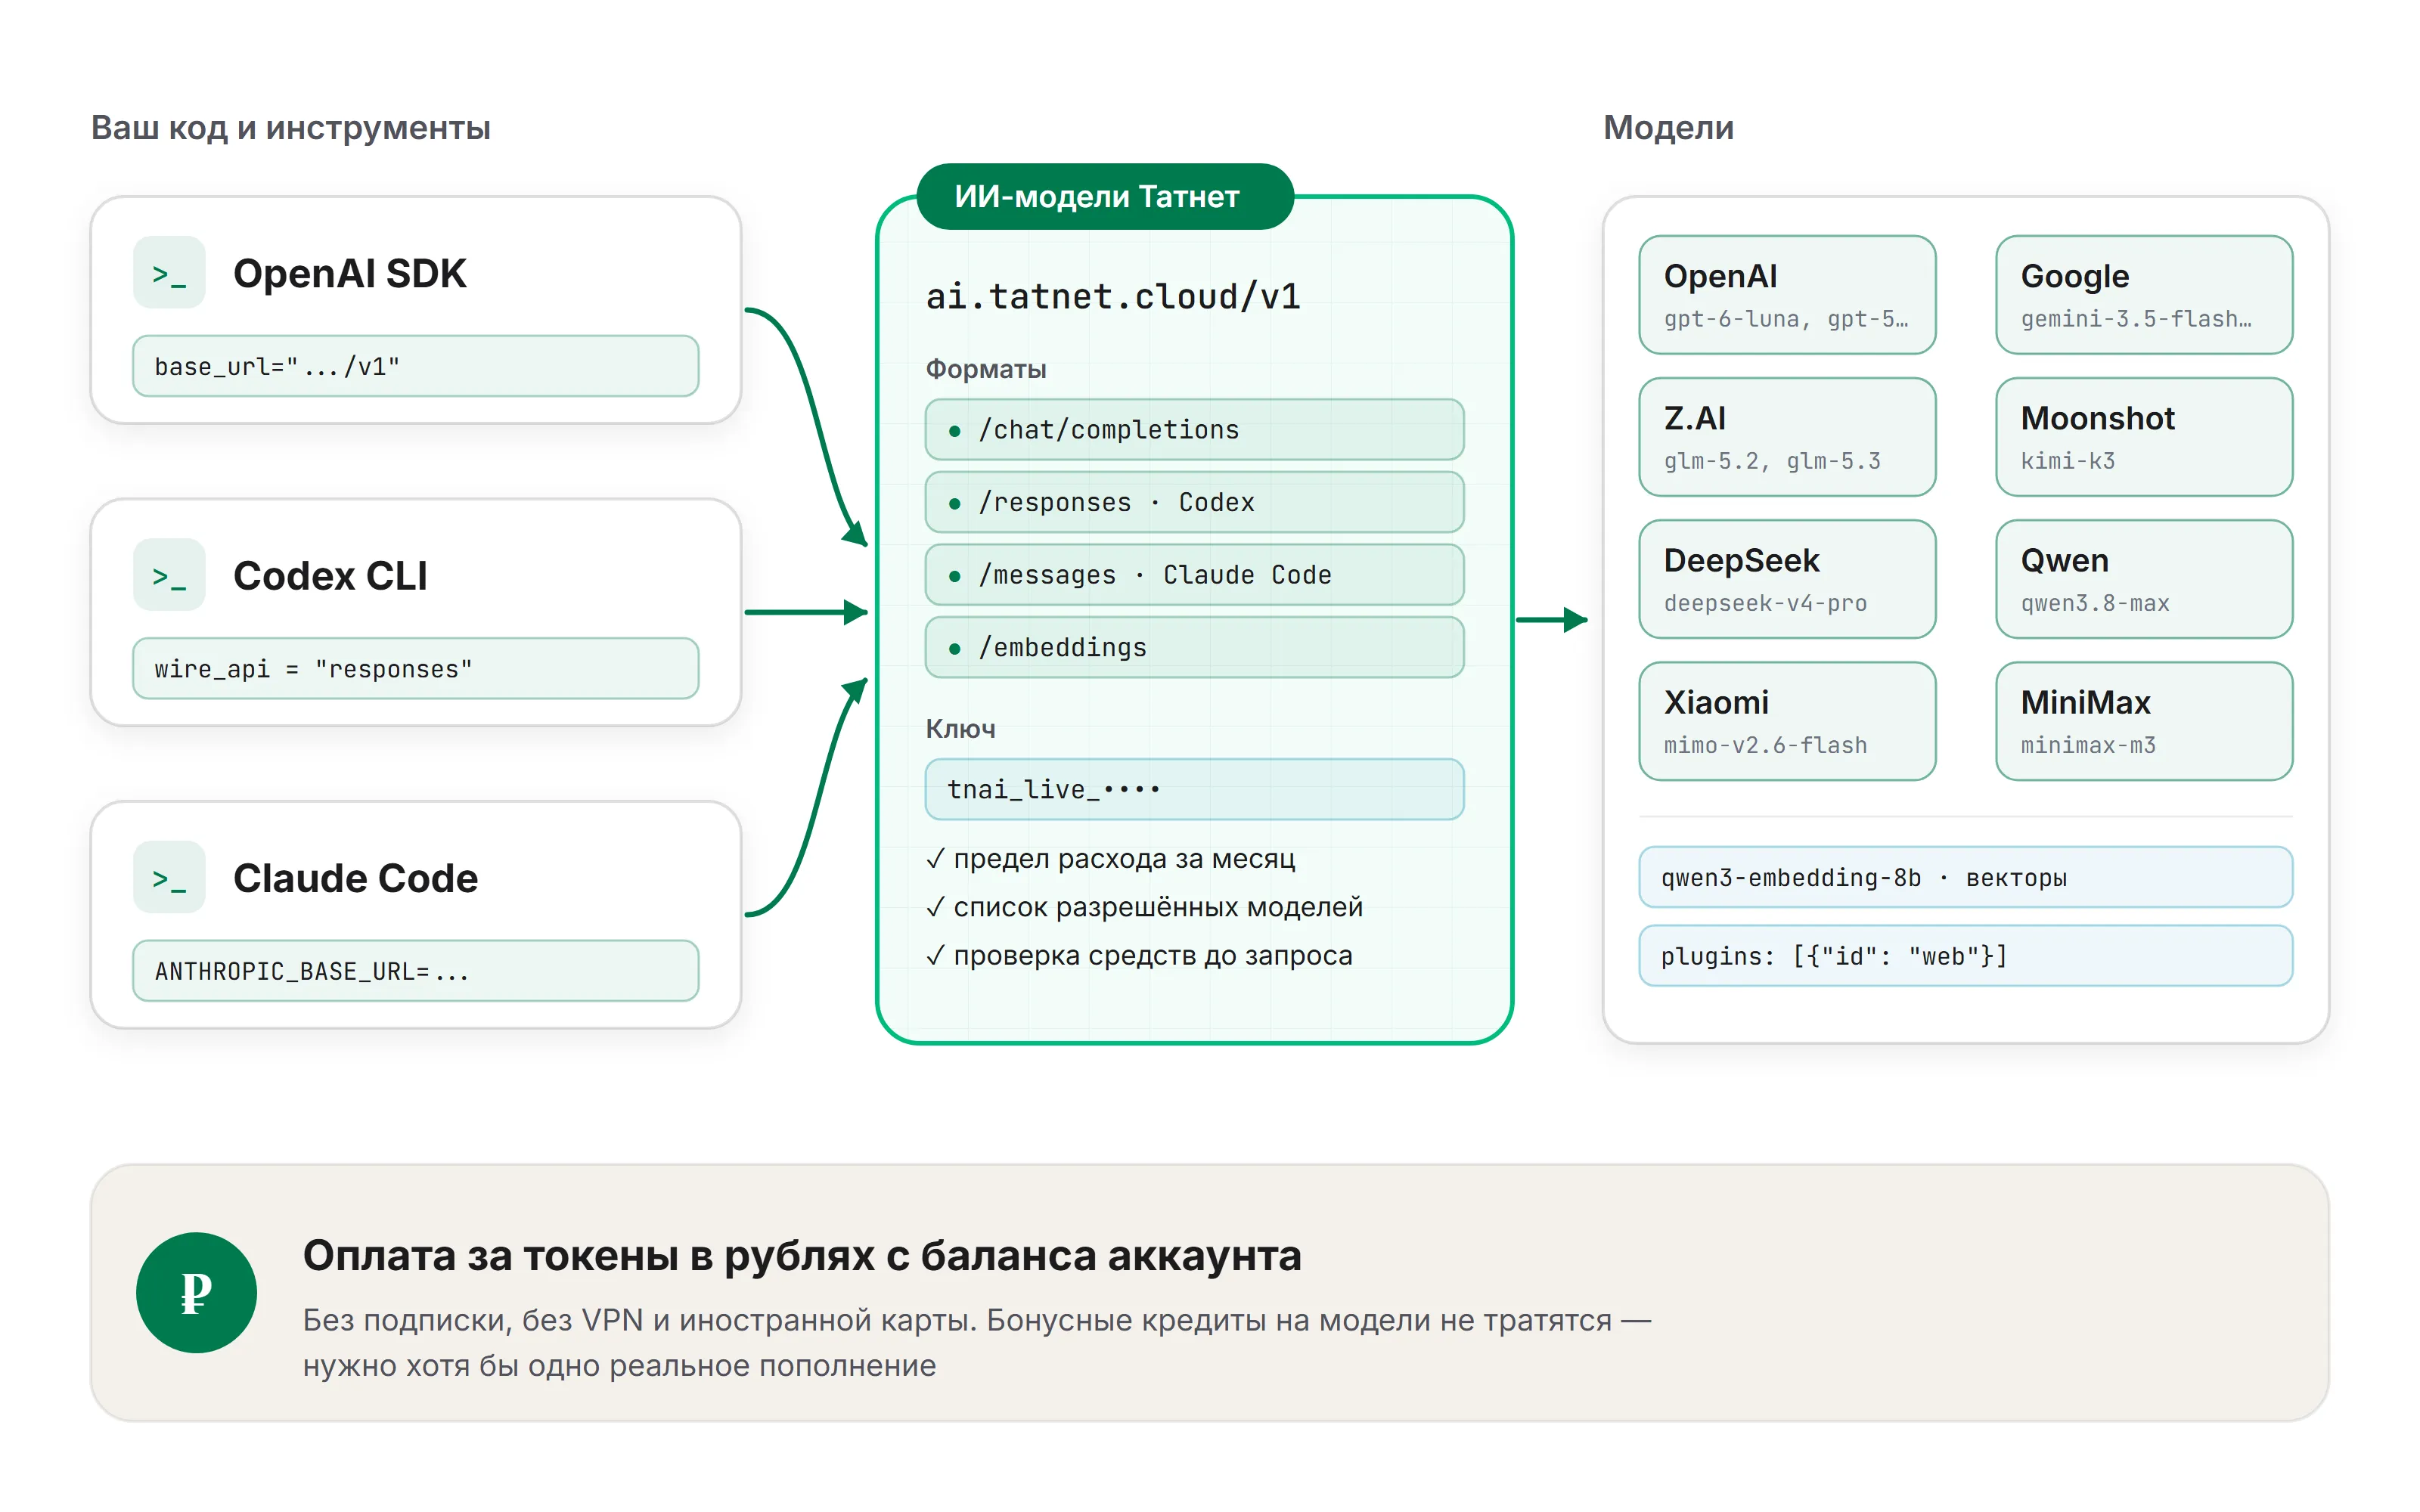
На Татнет есть ИИ-модели — один OpenAI-совместимый адрес, за которым стоят модели OpenAI и Google Gemini и открытые модели GLM, Kimi, DeepSeek, Qwen, MiMo и MiniMax. Код на OpenAI SDK переключается сменой базового URL и ключа, Codex — одним файлом настроек. Платите рублями с баланса аккаунта, без отдельной подписки.
Что получится в конце:
- ключ API с месячным лимитом трат, который не страшно отдать в CI;
- OpenAI SDK для Python и Node.js, который ходит в нужную модель;
- Codex CLI (и, если нужно, Claude Code) на тех же моделях без VPN;
- эмбеддинги для поиска и RAG и веб-поиск со ссылками на источники.
Шаг 1. Ключ с лимитом
В панели Татнет откройте раздел ИИ-модели и нажмите «Создать ключ». При создании можно:
- задать предел расхода за месяц. Если ключ утечёт, он упрётся в этот потолок, а не в весь баланс аккаунта;
- сузить список моделей. Ключу для CI, например, хватит одной дешёвой модели.
Ключ начинается с tnai_live_ и показывается один раз: Татнет хранит только его
хеш и повторно отдать не может. Сохраните его сразу в менеджер секретов, а в терминале
положите в переменную:
export TATNET_AI_KEY=tnai_live_...Ключ даёт доступ к платному API. Не коммитьте его в репозиторий и не отдавайте в код, который выполняется в браузере. Для разработки, стейджинга и продакшена удобнее завести разные ключи с разными лимитами — так же, как разные базы (подробнее — в статье про dev/stage/prod окружения).
Важно про оплату. Запросы к моделям списываются только реальными рублями с баланса. Бонусные кредиты на инференс не тратятся и доступ к нему не открывают: чтобы начать, баланс нужно хотя бы раз пополнить настоящими деньгами.
Шаг 2. Первый запрос
Проверяем ключ обычным curl:
curl https://ai.tatnet.cloud/v1/chat/completions \
  -H "Authorization: Bearer $TATNET_AI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.2",
    "messages": [{"role": "user", "content": "Привет"}]
  }'
Ответ приходит в том же формате, что у OpenAI:
{
  "id": "chatcmpl-8f3a…",
  "object": "chat.completion",
  "model": "glm-5.2",
  "choices": [{
    "index": 0,
    "message": {"role": "assistant", "content": "Привет! Чем могу помочь?"},
    "finish_reason": "stop"
  }],
  "usage": {"prompt_tokens": 9, "completion_tokens": 8, "total_tokens": 17}
}
По usage удобно считать расход в своём коде: за эти токены и спишутся деньги.
Список моделей с их возможностями и пределами отдаёт GET /v1/models:
curl https://ai.tatnet.cloud/v1/models{"id": "glm-5v-turbo", "object": "model", "owned_by": "tatnet",
"context_window": 202752, "max_output_tokens": 131072,
"capabilities": {"tools": true, "vision": true, "reasoning": true}}Цен в этом ответе нет: их показывает каталог в панели (раздел «ИИ-модели» → «Каталог»).
Шаг 3. OpenAI API через официальный SDK
Python
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://ai.tatnet.cloud/v1",
    api_key=os.environ["TATNET_AI_KEY"],
)

answer = client.chat.completions.create(
    model="glm-5.2",
    messages=[{"role": "user", "content": "Объясни, что такое VPC, в двух предложениях"}],
)
print(answer.choices[0].message.content)
VPC — это изолированная виртуальная сеть в облаке, внутри которой ваши серверы,
базы и кэш общаются по приватным адресам. Снаружи в неё попадает только то, что
вы явно открыли, например HTTPS к приложению.Node.js
import OpenAI from "openai";

const client = new OpenAI({
  baseURL: "https://ai.tatnet.cloud/v1",
  apiKey: process.env.TATNET_AI_KEY,
});

const stream = await client.chat.completions.create({
  model: "deepseek-v4.1-flash",
  messages: [{ role: "user", content: "Напиши регулярку для российского номера телефона" }],
  stream: true,
});

for await (const chunk of stream) {
  process.stdout.write(chunk.choices[0]?.delta?.content ?? "");
}
Ответ печатается по мере генерации:
Для номеров в форматах +7 900 123-45-67, 8 (900) 123-45-67 и 89001234567:

```
^(\+7|8)[\s(-]*\d{3}[\s)-]*\d{3}[\s-]*\d{2}[\s-]*\d{2}$
```

Перед сохранением номер лучше нормализовать: убрать всё, кроме цифр,
и заменить ведущую 8 на 7.
Потоковый режим работает как у OpenAI, включая stream_options.include_usage.
Вызов инструментов (tools) поддерживают модели с отметкой «инструменты» в каталоге,
картинки на входе (image_url) — модели с отметкой «картинки».
Если код менять нельзя. Официальные SDK OpenAI для Python и Node.js читают адрес и ключ из переменных окружения. Достаточно задать их в окружении приложения:
OPENAI_BASE_URL=https://ai.tatnet.cloud/v1
OPENAI_API_KEY=tnai_live_...
Если в коде уже указаны модели OpenAI или Gemini, их тоже можно не трогать: имена
моделей в Татнет совпадают с именами у вендоров (gpt-5.5, gpt-4.1-mini,
gemini-3.5-flash и так далее).
Две вещи, о которых стоит знать заранее:
- Потолок вывода. Если
max_tokensне задан, ответ ограничен 4096 токенами. Нужен длинный ответ — задайтеmax_tokensявно, но не выше предела модели. - Размышления. У моделей с размышлениями рассуждение тратит тот же
max_tokens, что и ответ. У DeepSeek размышления включены по умолчанию и на трудном вопросе могут съесть весь потолок (finish_reason: "length"). Для коротких ответов передавайте"reasoning_effort": "none"(дешевле и быстрее), для сложных — поднимайтеmax_tokens.
Шаг 4. OpenAI Codex CLI
Кроме Chat Completions, Татнет принимает формат OpenAI Responses API
(POST /v1/responses), а на нём работает Codex CLI. Настройка — в ~/.codex/config.toml:
model = "glm-5.2"
model_provider = "tatnet"

[model_providers.tatnet]
name = "TatNet"
base_url = "https://ai.tatnet.cloud/v1"
env_key = "TATNET_AI_KEY"
wire_api = "responses"
Запуск:
export TATNET_AI_KEY=tnai_live_...
codex
Дальше Codex работает как обычно. Например, в небольшом проекте todo-app
на Express просим добавить фильтр:
› Добавь в GET /todos фильтр по выполненным задачам: ?done=true|false

• Explored
  └ Read src/routes/todos.js, src/db.js
• Edited src/routes/todos.js (+9 -2)
• Ran npm test
  └ 6 passing
─ Worked for 41s ─
Готово: GET /todos принимает ?done=true|false. Без параметра возвращаются
все задачи, на неверное значение — 400. Добавил два теста в test/todos.test.js.
Codex работает с glm-5.2, kimi-k3 и deepseek-v4-pro: читает и правит файлы,
вызывает инструменты. На старте он предупредит, что не знает метаданных модели. На
работу это не влияет.
Чем этот вход отличается от API OpenAI:
- Ответы не хранятся,
previous_response_idне поддерживается: история передаётся целиком. Codex так и делает, а в своём коде используйтеstore: false. - Потолок вывода по умолчанию — 32 000 токенов. Codex не передаёт
max_output_tokens, поэтому при проверке средств перед запросом учитывается именно этот потолок. Если на балансе или в пределе ключа почти ничего не осталось, запрос отклонят, даже если ответ был бы коротким. - Встроенные инструменты OpenAI (веб-поиск, поиск по файлам) из запроса убираются. Свои функции работают.
Под Codex удобно завести отдельный ключ с небольшим месячным лимитом: в карточке ключа видно, во сколько обходится работа агента.
Бонус: Claude Code и Anthropic SDK
Тот же ключ принимает формат Anthropic Messages API (POST /v1/messages), поэтому
модели Татнет подключаются и к Claude Code:
export ANTHROPIC_BASE_URL=https://ai.tatnet.cloud
export ANTHROPIC_AUTH_TOKEN=tnai_live_...
export ANTHROPIC_MODEL=glm-5.2
# Claude Code ходит и в «быструю» модель — укажите нашу, иначе он запросит haiku
export ANTHROPIC_DEFAULT_HAIKU_MODEL=glm-5.2
claude
Работает на glm-5.2, kimi-k3 и deepseek-v4-pro: чтение и правка файлов, вызов
инструментов, размышления. Серверных инструментов Anthropic (веб-поиск, исполнение кода)
нет, такие инструменты из запроса убираются.
Какую модель выбрать
Адрес, ключ и формат запроса у всех моделей одинаковые: модель меняется одним полем
model. Начните с дешёвой и переходите на сильную, только если качества не хватает.
| Задача | Модели |
|---|---|
| Классификация, извлечение данных, короткие ответы, массовая обработка | mimo-v2.6-flash (самая дешёвая в каталоге), deepseek-v4.1-flash, gpt-6-luna |
| Агентные задачи и код, очень длинный вывод | minimax-m3, qwen3-coder-next (быстрый ответ без размышлений) |
| Код и агенты с длинным контекстом, Codex и Claude Code | glm-5.2, glm-5.3, deepseek-v4-pro |
| Самые сложные задачи, когда цена вторична | kimi-k3, qwen3.8-max, старшие модели GPT |
| Скриншоты, схемы, документы картинками | glm-5v-turbo, kimi-k3, qwen3.8-max, deepseek-v4.1-flash |
Окна контекста и пределы вывода у каждой модели — в
документации и в ответе /v1/models.
Эмбеддинги для поиска и RAG
Модель qwen3-embedding-8b превращает текст в вектор из 4096 чисел. Она
многоязычная, русский понимает, окно — 32 тысячи токенов.
result = client.embeddings.create(
    model="qwen3-embedding-8b",
    input=["Казань — столица Татарстана.", "Как добраться до Кремля?"],
    dimensions=1024,  # необязательно: короче вектор — меньше места в базе
)
vectors = [item.embedding for item in result.data]
print(len(vectors), len(vectors[0]), result.usage.prompt_tokens)
2 1024 19Два текста — два вектора по 1024 числа, за запрос посчитано 19 входных токенов. Векторы складываются в pgvector, Qdrant или любую другую векторную базу.
Платится только вход: число токенов во всех текстах запроса. Несколько текстов можно отправить одним запросом.
Веб-поиск со ссылками на источники
Модели не знают свежих новостей. Плагин web перед ответом ищет в интернете
(через Яндекс), кладёт найденные фрагменты в контекст, и модель отвечает со ссылками:
response = client.chat.completions.create(
    model="glm-5.2",
    messages=[{"role": "user", "content": "Что нового в Go 1.26?"}],
    extra_body={"plugins": [{"id": "web", "max_results": 5}]},
)
print(response.choices[0].message.content)
for a in response.choices[0].message.annotations or []:
    print("—", a.url_citation.title, a.url_citation.url)
В Go 1.26 главные изменения — в рантайме и стандартной библиотеке: новый сборщик
мусора включён по умолчанию, ускорены вызовы cgo, в go vet появились новые
проверки. Подробности — в release notes.
— Go 1.26 Release Notes https://go.dev/doc/go1.26
— Go 1.26 is released https://go.dev/blog/go1.26То же самое делает суффикс у модели: "model": "glm-5.2:online". Ссылки на источники
приходят в message.annotations, как у OpenAI и OpenRouter.
Плагин работает только в /v1/chat/completions. Если поиск не удался, запрос
завершается ошибкой web_search_failed. Модель при этом не вызывается и ничего
не списывается: ответа «без источников» вместо отказа вы не получите.
Ограничения и ошибки
Чего пока нет:
- PDF и аудио на входе: такой запрос сразу получает
400 unsupported_contentбез списания. Текст из PDF передавайте текстом, страницы — картинками; - генерации изображений;
- моделей OpenAI с суффиксом
-proиgpt-5.3-codex: вендор отдаёт их только через свой Responses API.
Ошибки приходят в обычной для OpenAI форме {"error": {...}}, всегда с причиной:
| Код | Что значит |
|---|---|
| 401 | Ключ не найден, отозван или выключен |
| 402 | Не хватает средств, не было реального пополнения или ключ упёрся в свой предел |
| 403 | Этому ключу модель не разрешена |
| 404 | Такой модели нет в каталоге |
| 503 | Не удалось проверить доступ — это не отказ по деньгам, повторите запрос |
Например, ключ для CI упёрся в месячный предел:
curl -s https://ai.tatnet.cloud/v1/chat/completions \
  -H "Authorization: Bearer $TATNET_AI_KEY" \
  -H "Content-Type: application/json" \
-d '{"model": "glm-5.2", "messages": [{"role": "user", "content": "Привет"}]}'{"error": {"message": "Ключ «ci» исчерпал предел расхода за месяц. Поднимите предел в карточке ключа или дождитесь нового месяца."}}Запрос отклонён до обращения к модели, поэтому ничего не списано. В коде ориентируйтесь на HTTP-код: 402 не стоит повторять в цикле, а 503 — можно.
Сколько это стоит
Как считается стоимость:
- За токены, в рублях. Отдельная цена за миллион токенов входа, вывода и чтения кеша. У эмбеддингов — только вход. Веб-поиск — цена за каждый поиск плюс найденный текст по ставке входа модели (обычно 4–6 тысяч токенов на 5 результатов).
- Без подписки. Платите только за запросы. Если запрос отклонён или ответ оборвался и счётчики токенов не пришли, он не тарифицируется.
- Длинный контекст дороже у части моделей (
gpt-6*,gpt-5.6*,gemini-3.1-pro-preview): если вход больше порога, весь запрос считается по повышенной ставке. Обе ставки и порог показаны в каталоге. - С реального баланса. Бонусные кредиты на инференс не тратятся.
Перед каждым запросом Татнет проверяет, хватит ли денег на худший случай: вход плюс максимальный вывод. Поэтому запрос, на который не хватает, отклоняется сразу и ничего не стоит. Расход по моделям и проектам виден в разделе «ИИ-модели» → «Расход».
Актуальные ставки — в каталоге моделей в панели и на странице тарифов.
Итого
- Создайте ключ с месячным лимитом и, если нужно, с узким списком моделей.
- В OpenAI SDK поменяйте базовый URL на
https://ai.tatnet.cloud/v1. Если код трогать нельзя, хватит переменныхOPENAI_BASE_URLиOPENAI_API_KEY. - Codex CLI подключается блоком
[model_providers.tatnet]сwire_api = "responses", Claude Code — переменнымиANTHROPIC_*. - Начинайте с дешёвой модели и переходите на сильную, когда качества не хватает:
меняется одно поле
model. - Для коротких ответов отключайте размышления, для длинных — задавайте
max_tokens.
Полный справочник — в документации ИИ-моделей. Если ИИ-функция — часть вашего сервиса, само приложение можно развернуть там же: об этом гайд «Как запустить сайт, backend или API». Список моделей и создание первого ключа — на странице ИИ-модели Татнет.