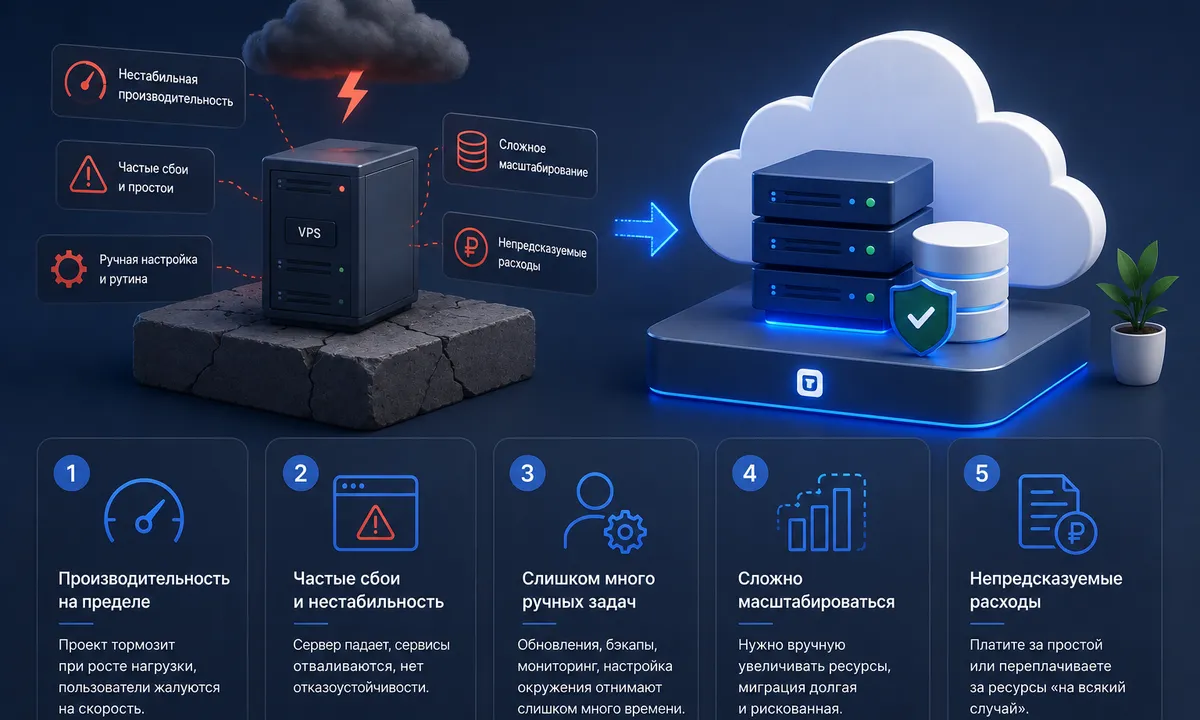
VPS — нормальный выбор для старта. Поднял Ubuntu, накатил nginx, настроил deploy-скрипт — и поехали. Многие проекты живут так годами, и это нормально работает.
Но в какой-то момент проект перерастает эту модель. Обычно не резко: не происходит одного большого падения, после которого всё становится понятно. Накапливаются мелкие неудобства. Растёт «налог» на эксплуатацию. Релизы становятся медленнее. Простые задачи требуют всё большего количества ручных шагов.
Статья — про симптомы, по которым видно, что точку перехода вы уже прошли.
Когда VPS — это нормально
Прежде чем разбирать признаки, важно проговорить: VPS — не плохая технология. Это рабочая модель для огромного количества сценариев.
VPS подходит, когда:
- проект небольшой, нагрузка предсказуемая;
- состав сервисов стабилен — один backend, одна база, всё;
- релизов немного, инфраструктура обновляется редко;
- в команде есть человек, который умеет администрировать сервер и не против тратить на это время;
- проекту нужен полный контроль над ОС.
Если эти условия выполняются — переезжать никуда не надо. VPS будет работать.
Дальше — про ситуации, когда они перестают выполняться.
Признак 1. Деплой превратился в отдельную работу
Самый ранний симптом. Замечается не сразу, потому что наступает постепенно.
Как это выглядит на практике:
- релиз в пятницу вечером воспринимается как риск, а не как обычная процедура;
deploy.shза год оброс костылями, и никто уже точно не помнит, зачем там вот этотsleep 5;- CI/CD-пайплайн полусломан — половина шагов работает, половина закомментирована;
- перед каждым релизом кто-то тестирует деплой на staging, потому что «мало ли»;
- между
git pushи реально работающим обновлением проходит 15–30 минут ручных действий.
Что это значит. Инфраструктурная рутина начала съедать продуктовое время. Команда решает не задачи пользователя, а задачи деплоя.
Простой мысленный тест. Засеките: сколько минут проходит от git push до того момента, когда обновление действительно работает в проде? Если меньше пяти — всё в порядке. Если десять и больше, и это требует чьего-то участия — точка перехода уже близко.
Признак 2. SSL, домены и nginx-конфиги стали чёрным ящиком
Второй симптом — критичные части инфраструктуры держатся на памяти одного человека.
Как это выглядит:
- сертификат не обновился автоматически, сайт упал, и пришлось разбираться, что случилось с certbot;
- никто в команде уже не помнит точно, что лежит в
/etc/nginx/sites-available— там есть конфиги для проектов, которые давно умерли; - добавление нового поддомена занимает полдня: правки nginx, перевыпуск сертификата, проверка DNS;
- если человек, который изначально настраивал сервер, в отпуске — тронуть конфиги боятся.
Что это значит. Bus factor проекта по инфраструктуре равен единице. Всё работает, пока работает один конкретный человек.
В нормальной ситуации SSL и роутинг — это вещи, о которых вообще не нужно думать. Они должны быть настроены один раз и обновляться автоматически. Если в вашем случае это не так, и периодически приходится «зайти на сервер и поправить» — это симптом.
Признак 3. База данных живёт на том же сервере, что и приложение
Самый недооценённый признак. Обычно про него вспоминают только после первого инцидента.
Как это выглядит:
- PostgreSQL или MySQL установлены рядом с приложением на том же VPS;
- бэкапы делаются cron-скриптом, который последний раз проверяли год назад (или не делаются вовсе);
- при пиковой нагрузке приложение и база конкурируют за CPU и память;
- если в приложении утечка памяти, OOM-killer может прийти за процессом базы — и упадёт всё одновременно;
- обновлять PostgreSQL страшно, потому что это значит планировать даунтайм, делать дамп, накатывать обратно, молиться;
- никто не знает, что произойдёт, если диск заполнится — и хочется не выяснять.
Что это значит. Один инцидент превращается в полный простой проекта. И главное — это исправимо. Managed-база, отдельный инстанс, нормальные бэкапы и мониторинг закрывают большую часть этих проблем. Но на чистом VPS всё это нужно настраивать и поддерживать самостоятельно, и обычно до этого руки не доходят.
Если вы держите прод-базу на том же сервере, что и приложение, и не делаете регулярных проверяемых бэкапов — это не «когда-нибудь надо будет переехать», а технический долг с плохой динамикой.
Признак 4. Когда нужно добавить второй сервис, начинается боль
Архитектура «одно приложение на одном сервере» хорошо масштабируется ровно до момента, когда сервисов становится больше одного.
Как это выглядит:
- появился Telegram-бот, и для него подняли отдельный VPS — потому что не хочется ставить рядом с основным приложением;
- появился воркер для фоновых задач — ещё один VPS;
- появился отдельный API для мобильного клиента — снова новый сервер;
- теперь у каждого свой SSH-доступ, свой nginx, свои сертификаты, свои deploy-скрипты — и всё это нужно поддерживать отдельно;
- сервисы должны общаться между собой, и приходится либо выставлять порты в интернет с какой-то базовой авторизацией, либо вручную поднимать VPN или WireGuard;
- общие переменные окружения копируются между серверами руками — и периодически рассинхронизируются.
Что это значит. Архитектура из одного приложения и одной базы — особый случай, который VPS обслуживает хорошо. Архитектура из нескольких сервисов с приватной коммуникацией между ними требует совсем другого инфраструктурного слоя: приватные сети, service discovery, единое управление переменными окружения и доступами.
На VPS всё это можно собрать самому. Но в какой-то момент сборка и поддержка такого «домашнего облака» начинает занимать больше времени, чем сама разработка продукта.
Признак 5. Команда выросла, а доступ к серверу — это всё ещё SSH-ключ
Последний признак — про команду.
Как это выглядит:
- единственный способ дать новому разработчику доступ к проду — добавить его публичный ключ в
authorized_keys; - ролей нет: либо у человека есть root, либо он не может почти ничего;
- нет аудита — невозможно ответить на вопрос «кто и когда последний раз менял конфиг nginx»;
- кто-то однажды задеплоил вручную через SSH, минуя пайплайн, и поломал прод — но узнали об этом не сразу;
- онбординг нового разработчика в инфраструктуру занимает полдня, и каждый раз это уникальный квест.
Что это значит. VPS не предполагает командной работы из коробки. Это инструмент уровня одного человека или маленькой команды, которая полностью доверяет друг другу.
Когда команда растёт, нужны вещи, которых на чистом VPS нет: разграничение прав, аудит изменений, отдельные доступы для разработчиков и для прода, понятный процесс деплоя без ручного SSH. Всё это можно построить поверх VPS — но это снова работа, которая не относится к продукту.
Что делать, если узнали себя
Если по списку набралось один–два признака — пока терпимо. Это нормальное состояние растущего проекта, и его можно подержать ещё какое-то время.
Если три и больше — это уже не «когда-нибудь переедем», а технический долг, который растёт сам по себе. Каждая новая фича делает миграцию чуть сложнее.
Альтернатив у VPS несколько, и ключевая развилка такая.
Остаться на уровне ОС. Перейти на другой VPS побольше или на IaaS-облако. Это решает проблему ресурсов, но не решает ни одной из перечисленных выше — деплой, SSL, базы, сети и доступы вы по-прежнему настраиваете сами.
Подняться на уровень платформы. Перейти на PaaS, где сборка, деплой, домены, HTTPS, обновления, приватные сети и managed-базы работают из коробки. Это решает большинство симптомов из статьи, но накладывает свои ограничения — менее гибкая работа с уровнем ОС.
Какой вариант подходит — зависит от того, что в проекте важнее: полный контроль над сервером или скорость и предсказуемость эксплуатации.
Сравнить TatNet с VPS
TatNet — PaaS-платформа, которая закрывает те самые сценарии, где обычный VPS начинает буксовать.
Что вы перестаёте делать руками после переезда:
- настраивать nginx, certbot и SSL — HTTPS работает автоматически;
- писать
deploy.sh— деплой запускается из Git при push; - держать базу на том же сервере, что и приложение — managed-сервисы работают как отдельные ресурсы с бэкапами и мониторингом;
- поднимать второй VPS под каждый новый сервис — приложения, microVM и serverless-функции связываются приватной сетью внутри платформы;
- раздавать SSH-доступы — командная работа строится через клиентский кабинет, а не через
authorized_keys.
Если симптомы из статьи звучат знакомо, посмотрите, как это устроено.
Итог
VPS не становится плохим инструментом в один момент. Он остаётся тем же, что и был, — просто проект растёт и требует другого.
Признаки перехода легко пропустить, потому что каждый из них в отдельности кажется мелочью. Долгий деплой — ну, потерпим. Сертификат не обновился — поправим. База упала вместе с приложением — больше так не будем. Но в сумме это и есть тот самый «налог на инфраструктуру», который растёт незаметно и съедает продуктовое время.
Если узнали в статье свой проект — это не повод срочно переезжать. Это повод посчитать, сколько часов в месяц команда тратит на эксплуатацию, и решить, готовы ли вы тратить столько же дальше.